阿摩線上測驗
登入
首頁
>
國營事業◆1.統計學 2.巨量資料概論
>
104年 - 104 經濟部所屬事業機構_新進職員甄試_統計資訊:1.統計學 2.巨量資料概論#71785
> 試題詳解
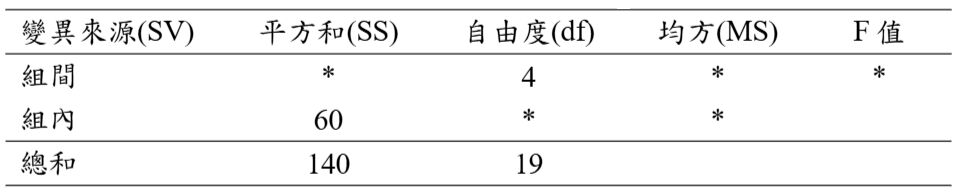
32. 下表是一個不完整的變異數分析表(ANOVA table),請問檢定統計量 F 值為何?
(A) 0.2
(B) 4.0
(C) 5.0
(D) 6.0
答案:
登入後查看
統計:
尚無統計資料
相關試題
33. 欲建立母體均數的區間估計值,假設使用36個觀察值時,其母體均數的區間估計值為 19.76 ± 1.32,則當樣本大小n以144取代36時,其母體均數的區間估計值應為下列何者? (A) 19.76 ± 2.64 (B) 19.76 ± 0.66 (C) 9.88 ± 2.64 (D) 4.94 ± 1.32
#4068693
34. 某甲收集100筆資料,其平均值為50,變異數為100,中位數為60。請問下列何者正確? (A)至少有75筆資料值介於30與70之間 (B)大約有95筆資料介於30與70之間 (C)這100筆資料分佈為右偏 (D)這100筆資料分佈為對稱
#4068694
35. 卡方分配(chisquare distribution)可應用在下列哪項? (A)推論單一母體的變異數 (B)檢定配適度 (C)檢定兩個變數的獨立性 (D)以上皆是
#4068695
36. 透過迴歸分析演算法可以進行資料關連性分析。現考量運用三種行銷廣告通路:電視、廣播、報紙的預算金額分配額度大小,找出它們對於產品銷售值(sales)的影響。請問下列敘述何者有誤? (A)電視、廣播、報紙三種特徵值為獨立變數,而sales是我們要預測的結果,因此為相依變數 (B)對於獨立變數如電視、廣播、報紙,我們允許使用連續量化變數,同時也允許使用類別式變數(categorical variable)兩種資料型態,但是我們對於相依變數sales,僅允許使用類別式變數型態,因此一般性的迴歸分析演算法可以用來進行資料分類 (C)三種變數是否要納入迴歸分析方程式可以透過Tstatistic的檢驗,並考量其Fstatistic值越大、pvalue的值愈小的變數者,其較具有影響力 (D)迴歸分析方程式有時需要考量獨立變數所表示特徵值是否有交互作用,而判斷交互作用的影響力也可運用Tstatistic的檢驗,並透過高Fstatistic值和低pvalue值來判斷
#4068696
37. 透過統計學習方法論,我們希望找出一個決策樹資料分類器以避免資料分類時的過度解讀(overfitting),請問對於資料過度解讀的現象,下列何者有誤? (A)決策樹分類器對於訓練資料集過度解讀,可以提高對於訓練資料集分類結果的準確率 (B)過度解讀對於測試資料的分類判斷結果其準確率很低 (C)我們可以用簡單決策樹分類器模型,來避免產生訓練資料集過度解讀的現象 (D)當每一次納入新的特徵值來成長決策樹結構時,當新增特徵值對於訓練資料集無法產生有效分類就該停止,因此用事後修剪決策樹的方法將無法避免資料過度解讀
#4068697
38. 對於巨量資料分析Spark平台,下列何者有誤? (A) Spark有提供結構化資料格式的巨量資料分析功能 (B) Spark能夠透過多種電腦語言,如Scala, Python, R, Java來呼叫系統引擎 (C) Hadoop原有的MapReduce巨量資料分析的計算原理無法在Spark上來進行 (D) Spark是選擇Apache開放性系統發展模式,因此我們可以看到Spark系統的原始程式碼
#4068698
39. 一般推薦系統(Recommender System)時常會採用下列哪一個方法作為核心技術,來估計產品與使用者間的可能關係? (A) Matrix Factorization (B) Hashing (C) Linear Discriminative Analysis (LDA) (D) PartofSpeech (POS) Tagging
#4068699
40. 下列何種統計學習的演算法是用來進行資料的分群(Clustering),但不能用來進行資料分類(Classification)? (A) KMeans (B) Bayes Nets (C) Logistic Regression(D) Support Vector Machine
#4068700
41. 巨量資料中的資料類別出現的頻率,時常會形成所謂的長尾現象,一般可利用以下哪種統計工具來描述此種形式的資料分佈? (A) Zipf (B) Gaussian (C) Dirichlet (D) Uniform
#4068701
42. 以分析使用者打卡(check in)的應用為例,如果打卡的位置為變數X。使用者A習慣在一個位置打卡(如公司),其打卡位置的分佈統計模型為P$_{A}$(X);使用者B時常在都市內到處打卡,其分佈統計模型為P$_{B}$(X)。請問何者的entropy,也就是H(.)較高? (A) 使用者A (B) 使用者B (C) 兩者一樣 (D) 無法比較
#4068702
相關試卷
115年 - 115 經濟部所屬事業機構_新進職員甄試試題_統計資訊:1 .統計學 2 .巨量資料概論#146943
2026 年 · #146943
113年 - 113 經濟部所屬事業機構_新進職員甄試試題_統計資訊:1.統計學 2.巨量資料概論#136987
2024 年 · #136987
112年 - 112 經濟部所屬事業機構_新進職員甄試_統計資訊:1.統計學 2.巨量資料概論#116948
2023 年 · #116948
111年 - 111 經濟部所屬事業機構_新進職員甄試_統計資訊:1.統計學 2.巨量資料概論#111345
2022 年 · #111345
110年 - 110 經濟部所屬事業機構_新進職員甄試_統計資訊:1.統計學 2.巨量資料概論#103701
2021 年 · #103701
109年 - 109 經濟部所屬事業機構_新進職員甄試_統計資訊:1.統計學、2.巨量資料概論#92857
2020 年 · #92857
108年 - 108 經濟部所屬事業機構_新進職員甄試_統計資訊:1.統計學 2.巨量資料概論#80775
2019 年 · #80775
107年 - 107 經濟部所屬事業機構_新進職員甄試 _統計資訊:1.統計學 2.巨量資料概論#92213
2018 年 · #92213
106年 - 106 經濟部所屬事業機構_新進職員甄試_統計資訊:1.統計學#71742
2017 年 · #71742
106年 - [非官方正解]106 經濟部所屬事業機構_新進職員甄試_統計資訊:2.巨量資料概論#71719
2017 年 · #71719
 阿摩線上測驗
登入
阿摩線上測驗
登入